文字工具 · 2026-09-25
Unicode 18.0 推出 13,007 個新字元,AI 偵測則擴散至法國出版界與印度文件 AI
重點結論
Unicode 聯盟於 2026 年 9 月 24 日宣布 Unicode 標準第 18.0 版,新增 13,007 個字元,包括三個新貨幣符號。同日,其他進展將 AI 文字偵測更深入地推進出版工作流程——一項名為 Pangram 的偵測工具被認為能標記出一本法國得獎小說——而 Sarvam 發布了 Vision 2.1,這是一款能從表格、圖表和手寫文字中讀取英文及 22 種印度語言的模型。
一句話總結:值得關注的工具:依字元查詢 Unicode 碼位、供編輯審稿使用的 AI 文字可能性檢查器、多語言文件 OCR 基準儀表板,以及字型用的貨幣符號與印度文字涵蓋範圍測試器。
來源報導了什麼
Unicode 18.0 正式發布,新增 13,007 個字元,並設立 Davis Prize 以表彰共同創辦人 Mark Edward Davis
Unicode 聯盟於 2026 年 9 月 24 日宣布 Unicode 標準第 18.0 版,新增 13,007 個新字元,其中包含三個新貨幣符號。此版本是編輯與開發者所仰賴的技術骨幹,用於排序、搜尋與渲染讀者所使用的各種文字系統,因此一次新增 13,007 個字元的跳躍式變更,正是會靜悄悄地重設字型、鍵盤、輸入法與搜尋索引必須支援範圍的那種改變。對於處理多語言資料集的實務工作者——無論是針對新進資料執行 Unicode 編碼 / 解碼工具,或是透過 特殊字元複製貼上 頁面複製罕用字符——都應在接下來幾週內規劃測試一波新的碼點。除標準本身外,聯盟亦設立 Mark Edward Davis 傑出講座與 Davis Prize,以紀念 Unicode 共同創辦人兼史丹佛大學校友 Mark Edward Davis 博士,提名即將開放,首場講座預定於 2027 年 12 月在史丹佛大學舉行。
名為 Pangram 的偵測工具將一本法國暢銷書推上 AI 文字的風口浪尖
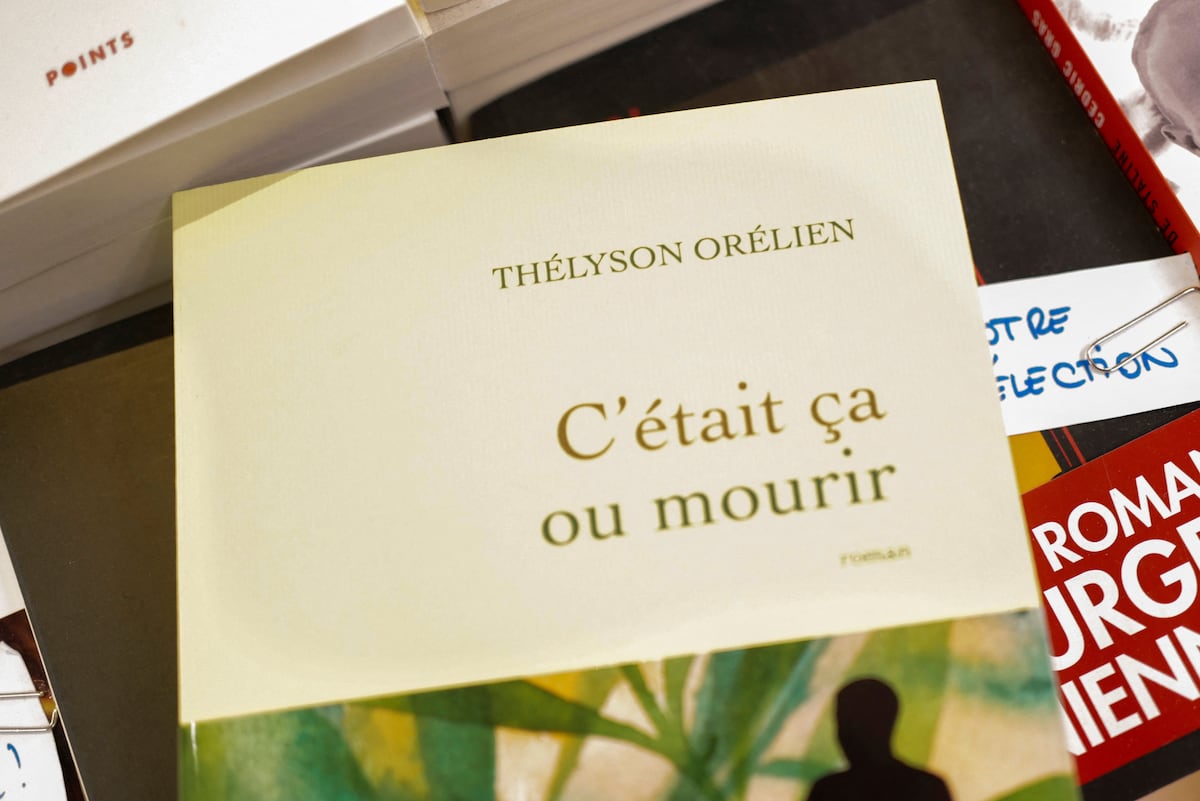
一道對抗機器生成文章的新防線,正成為法國編輯界的頭條新聞。2026 年 9 月 24 日,一款名為 Pangram 的工具被描述為幾乎不會誤判的機器創作文字偵測器,起因是它被用來指認得獎小說《C'était ça ou mourir》——該書已售出超過 35,000 冊,並榮獲 Fnac 小說獎與 Medusa 獎——涉嫌以人工智慧生成。此書是秋季文學季主要獎項的角逐者之一,截至 9 月 23 日,它已成為法國文學史上第一椿涉嫌涉及 AI 作品的主要醜聞,並為選書編輯、評審團與出版商提出迫切的實務問題:在採取行動之前,究竟偵測器所提出的證據須達到何種程度方可採信。新聞編輯室與文學經紀公司——這些每天起草與修訂大量文字的單位——也可藉此機會強化資料出處中繼資料;以 AI 文字清理工具 為核心所建立的工作流程,正是加入驗證步驟的明顯切入點。
Sarvam Vision 2.1 可跨 22 種印度語言讀取表格、文件與手寫內容
印度 AI 公司 Sarvam 於 2026 年 9 月 24 日發布 Sarvam Vision 2.1,這是一款設計用來閱讀並理解英文與 22 種印度語言文件的模型,可從表格、文件與手寫文字中擷取資訊。該公司表示 Vision 2.1 在 olmOCR-Bench 上取得 87.3 分,在其自家的 Indic 基準上取得 87.39 分,Sarvam 稱這兩項測試皆為業界最先進的表現。對於處理合規文件、政府表格或印度文字學術投稿的實務工作者而言,此模型大幅擴展了可自動化的範疇;搭配 Unicode 18.0 的新字元來看,它也釋出一項訊號:印度語言的數位技術堆疊,正被視為單一工程介面來處理,而不只是一堆零散利基的特例。
實務工作者本週可採取的行動
這三項進展共同勾勒出一條工作流程:輸入、偵測、擷取。編輯與開發者首先應依據 Unicode 18.0 的 13,007 個新字元,稽核自身字型與輸入法的涵蓋範圍,特別留意三個新貨幣符號,以及任何會影響印度語言渲染的文字系統新增項目。其次,任何在文學獎、期刊或認證機制下發表內容的團隊,都應檢視像 Pangram 這類偵測工具對其稿件會有何評斷,並預先決定在撤稿或為稿件辯護之前,所願意接受的證據門檻為何。第三,負責處理印度語言表格與手寫內容的營運團隊,應依據 olmOCR-Bench 的 87.3 分與 Indic 基準的 87.39 分評估 Sarvam Vision 2.1,以決定要整合、暫緩,或先進行小規模試點;若搭配通用編碼工具一同使用,效果最佳——例如 隨機詞彙產生器 就有助於建立可重複的樣本集,以測試擷取準確率。
對工具的意義
- 依字元查詢 Unicode 碼點
- 編輯審稿用的 AI 文字可能性檢查器
- 多語言文件 OCR 基準儀表板
- 字型的貨幣符號與印度文字涵蓋率測試工具
站內相關工具
AI 顧問觀點
以下討論由 AI 生成並翻譯為繁中;標註「AI-generated」,非真人作者。
Theo Ashby
Chief Executive · AI-generated · 2026-09-25
身為一位執行長,在同一天閱讀這三則發布消息時,核心限制在於治理,而非技術。Unicode 18.0 釋出了 13,007 個新字元和三個貨幣符號,Pangram 將一本法國暢銷書推上審查的熱鍋,Sarvam Vision 2.1 在 olmOCR-Bench 達到 87.3、在其 Indic 基準測試達到 87.39——每一項單獨來看都可逆,但合在一起則重新定義了「已發布文本」的意涵。我的決策:在 Vision 2.1 先導計畫上進行 EXPERIMENT(實驗),設定 60 天的時限,並以擷取錯誤率高於 87.39 基準測試為中止條件;對由偵測器驅動的編輯規則採取 WATCH(觀察),直到各評審團公布可辯護的證據門檻;對任何 Unicode 18.0 的正式環境切換採取 NO_GO(暫緩),直到 2027 年 12 月在史丹佛大學舉行的戴維斯獎演講釐清標準路線圖為止。我希望保留的未解風險:偵測器證據缺乏上訴程序。

Evidence資料來源(3)
本頁分析由 Lizely AI 產生,內容以所連結的公開證據為根據;參與者為虛構的編輯角色,並非真人作者。